

Introduction & Contexte
Ce projet a été réalisé pour le Mastère Expert en Ingénierie du Logiciel avec l’ISCOD, dans le cadre d’une mise en situation professionnelle. En tant que développeur full-stack, l’objectif de concevoir de A à Z la plateforme PMT (Project Management Tool), une application web moderne destinée aux équipes de développement, leur permettant de planifier, de suivre et de collaborer efficacement sur des projets divers.
Ce projet exigeait la maîtrise transversale de toutes les couches de l’ingénierie logicielle, de la modélisation des données jusqu’à l’industrialisation des livrables.
Les objectifs du projet
Les objectifs de cette réalisation comportent à la fois des objectifs techniques et fonctionnels.
Objectifs techniques
Les objectifs techniques étaient les suivants:
Concevoir une architecture robuste et évolutive en s’appuyant sur Angular côté Frontend et Spring Boot (Java) côté Backend.
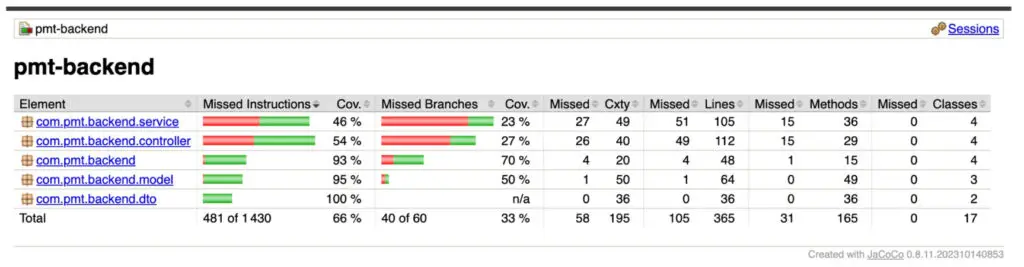
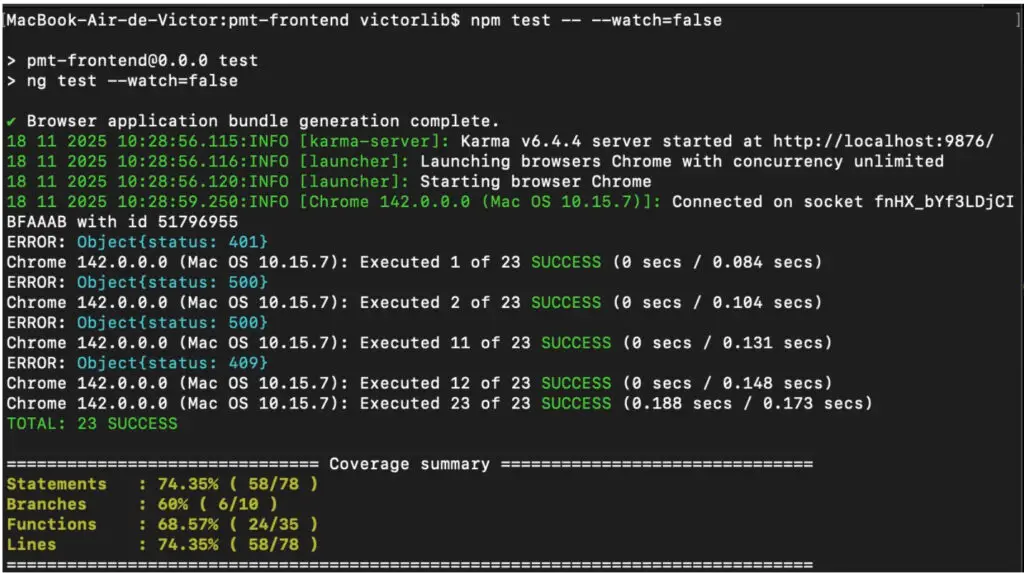
Garantir la fiabilité du code via une couverture de tests automatisés (instructions et branches) strictement supérieure à 60 %.
Objectifs fonctionnels
Pour la partie fonctionnelle, les objectifs étaient les suivants :
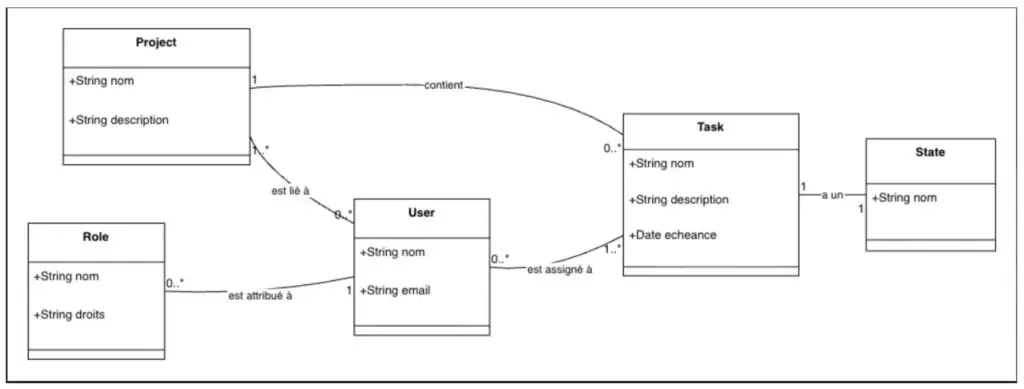
Modéliser un système relationnel cohérent structuré autour des entités Utilisateur, Projet, Tâche, Rôle et Statut.
Implémenter les fonctionnalités métiers en application concrète de la méthodologie Agile, sous forme de User Stories.
Livrables
Un schéma de base de données et son script SQL de génération (structure + données de test).
Un repository Git à jour, hébergeant l’ensemble du code source (pmt-backend et pmt-frontend), disponible publiquement sur GitHub.
Des rapports de couverture de code, backend et frontend, générés automatiquement.
Une chaîne d’intégration continue opérationnelle, les Dockerfiles backend et frontend, et un fichier README.md documentant la procédure de déploiement.
Enjeux, Risques & Contraintes
L’exigence de la Qualité et de l’Industrialisation
Pour ce projet, il ne s’agissait pas uniquement de coder, mais de configurer une chaîne d’intégration continue (CI/CD) capable de bloquer automatiquement tout déploiement en cas d’échec des tests unitaires. Toujours dans le cadre de ce projet, il fallait également prendre en compte l’ajout soudain d’un système d’inscription et d’authentification robuste avec Spring Security et tokens JWT en cours de projet a nécessité une réadaptation rapide de l’architecture.
Cependant, ce projet n’a pas été un long fleuve tranquille et j’ai été confronté à quelques incidents. En effet, j’ai dû par exemple dû faire face à un conflit d’architecture majeur lié à Angular : la migration forcée de l’ancienne méthode NgModule vers la méthode moderne Standalone. Cela a généré de nombreuses erreurs de compilation, imposant une refactorisation complète pour reprendre le projet sur de bonnes bases et une perte de temps conséquente.
Les différentes étapes du projet
Conception & Modélisation des données
Comme à chaque entame de projet, il est essentiel de correctement poser les bases. Cela prend en compte l’identification des éléments de la base de données, l‘analyse des besoins fonctionnels et création des diagrammes de classes UML pour cartographier les relations. Pour l’occasion, veuillez retrouver mon diagramme de classes qui résume les éléments évoquées ci-dessus.
Développement Backend (Spring Boot & MVC)
Pour cette partie et comme évoqué dans les consignes initiales de ce projet, j’ai eu recours à Spring Data pour interagir avec une base de données relationnelles.
Voici comment j’ai procédé :
Création des modèles (models) : Elle représente la table des utilisateurs en base de données accompagnées des champs suivants : (id, nom, email, motDePasse). C’est aussi à cette étape que l’entité JPA est définie.
Création des repositories (repositories) : C’esi ici que l’interface Spring Data JPA est créé et est fournit automatiquement toutes les méthodes CRUD.
Création des Services (services) : Dans la couche Service se situe la couche de logique métier une fois implémentée. Elle gère également les opérations CRUD en s’appuyant sur les repositories.
Création des contrôleurs (controllers) : Le contrôleur gère l’ensemble des requêtes HTTP (GET, POST, PUT, DELETE) sur l’URL /api/users et les transmettre ensuite au UserService également vu précédemment.
Une fois arrivée à ce stade du développement, le backend peut alors créer, lire, mettre à jour et supprimer des utilisateurs de façon autonome grâce à l’API REST. De plus, cela permet d’avoir à la fois une application qui est peu impacté en cas de changement de la base de données, mais également d’avoir une logique métier qui ne dépend pas d’une requête HTTP.
C’est pourquoi j’ai également eu recours au DTO (Data Transfert Object). Il s’agit d’un objet qui est généralement utilisé pour réaliser des transferts. des données entre les couches d’une application. Les DTO sont généralement composés de getters et setters, qui correspondent aux différents champs de données à transmettre.
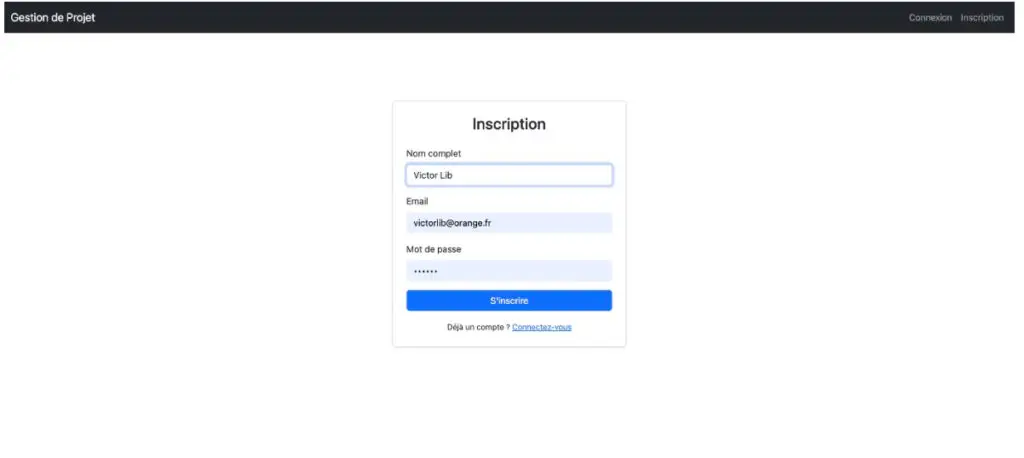
Une fois le backend conclut, une SPA (Single Page Application) a été conçu dans le but d’interagir avec cet même backend.
Développement Frontend (Angular) & Pivot vers l’Agilité
Face aux difficultés de la migration Standalone et à l’ajout de la sécurité, j’ai abandonné l’approche « Cycle en V » pour adopter une démarche en Méthodologie Agile. Il s’agit d’un mode de développement itératif par « briques » fonctionnelles.
Elle a été construite via trois fonctionnalités complètes que voici :
Avant la connexion/inscription au profil utilisateur :
- Lien de connexion
- Lien d’inscription
Après la connexion/inscription au profil utilisateur :
- Gestion des Utilisateurs : Un CRUD (Create – Read – Update – Delete) simple.
- Gestion des Projets : Un CRUD avec une relation (un Projet est lié à un User).
- Gestion des Tâches : Un CRUD avec deux relations (une Tâche est liée à un Project et à un User).
Il était initialement recommandé de développer une première fonctionnalité de A à Z (en commençant par le backend puis le frontend, une seconde, puis une troisième et ainsi de suite.
Phase sur les tests Automatisés
Une fois la phase de développement de notre application terminée et comme mentionné précédemment dans les consignes, il est évidemment essentiel de procéder à une phase de test permettant de nous assurer du bon fonctionnement de notre outil. Toujours à l’aide des consignes et de mes connaissances personnelles, voici comment j’ai procédé : Il faut mentionner donc que la phase de tests s’est déroulé en deux parties :
Backend :
Tests unitaires (@WebMvcTest) et d’intégration (@SpringBootTest) validant 66% du code (Couches Controller, Service, Repository).
Frontend :
Utilisation de Karma/Jasmine pour tester les services, les composants d’authentification et les scénarios d’erreurs (ex: erreur 409 Email déjà utilisé), atteignant 74,35% de couverture.
Industrialisation & CI/CD (DevOps)
Pour cette dernière partie, une chaîne d’intégration et de livraison continue a été mise en place. Cette approche a pour objectif de rationaliser et d’accélérer le cycle de vie de développement des logiciels et qui désigne l’intégration et la distribution ou le déploiement continus.
Voici comment cela a été mise en place :
- Docker : L’application PMT a été « dockerisée » en suivant une approche dite « Multi-Stage Build ». En effet, cela a permis d’optimiser la taille des images finales et de séparer l’environnement de construction de l’environnement d’exécution.
- Backend (pmt-backend/Dockerfile) • (Build) : Utilisation d’une image « maven:3-eclipse-temurin-21 » pour compiler le projet et générer le fichier .jar.
- (Run) : Utilisation d’une image légère « eclipse-temurin:21-jre-alpine. » Frontend (pmt-frontend/Dockerfile) :
- (Build) : Utilisation d’une image node:20-alpine qui permet installer les dépendances et construire l’application Angular .
- (Run) : Utilisation d’un serveur Nginx pour servir les fichiers statiques générés.
- Configuration Nginx : La configuration spécifique a été injectée pour rediriger toutes les routes vers index.html, nécessaire pour le fonctionnement d’une Single Page Application.
Retour d’expérience & Perspectives d’avenir
Cette expérience m’a appris, parfois à mes dépens, qu’un développement strictement séquentiel en cycle en V devient dangereux face à des exigences changeantes, comme l’a démontré l’ajout tardif et non anticipé de la sécurisation applicative. L’adoption d’une démarche itérative et Agile, par brique fonctionnelle complète, m’a permis de livrer des fonctionnalités concrètes à chaque étape, d’anticiper plus tôt les erreurs de conception d’API, et de finaliser le projet avec une bien plus grande aisance malgré les deux incidents majeurs rencontrés. Aujourd’hui, la pipeline CI/CD est pleinement opérationnelle et fiable.
À l’avenir, j’envisage de déployer ces conteneurs Docker directement sur une infrastructure Cloud (AWS ou GCP) afin de rendre l’outil accessible publiquement au-delà d’un environnement de démonstration local, et d’enrichir la plateforme de tableaux de bord analytiques dédiés au suivi de la productivité des équipes, capitalisant ainsi sur le modèle de données déjà en place (relations Projet/Tâche/Utilisateur) pour produire des indicateurs de pilotage à plus forte valeur ajoutée métier.